Wirtualizacja czy konteneryzacja – co musi znać każdy DevOps?
W jednym z poprzednich wpisów „Od kodera do DevOps inżyniera” napisałem o tym, dlaczego warto wyjść poza samego backendowego ifa i else’a. A jeśli zdecydujesz się na wejście do tej króliczej nory jaką bez wątpienia jest ścieżka devops, prędzej czy później trafisz nie tylko na hasła konteneryzacja, ale również wirtualizacja oraz Kubernetes.
Te nazwy brzmią jak morskie potwory z mitologii greckiej, ale spokojnie, nie są aż tak groźne ale za to równie potężne.Wirtualizacja, czyli klasyczny tytan
Zaczniemy od wirtualizacji. To technologia, która pozwala tworzyć „komputery w komputerze”. Każdy z własnym systemem operacyjnym, własnym środowiskiem i kompletną izolacją.
Brzmi solidnie? Bo jest. Ale też ciężko, ponieważ każda wirtualna maszyna potrzebuje sporo pamięci, CPU i miejsca. Trochę jakbyś odpalał drugiego Windowsa tylko po to, żeby uruchomić na nim jedną aplikację. Do testów, czy do symulacji? Super. Do codziennego uruchamiania aplikacji? No średnio bym powiedział.Kontenery, czyli lekko, szybko i zwinnie
Kontenery to takie „pudełka” na aplikacje. Ale zamiast całego systemu operacyjnego pakujesz tylko to, co naprawdę potrzebne. Potrzebujesz kodu aplikacji? To masz. Potrzeba ci jakichś zależności? Proszę bardzo. A może jakieś specyficzne konfiguracje? Częstuj się.
Dzięki takiemu podejściu kontenery uruchamiają się błyskawicznie, nie marnują zasobów, a działają dokładnie tak samo wszędzie. U Ciebie na laptopie, na serwerze, w pracy (nawet u kolegi), czy na AWS-ie.
Najpopularniejszym narzędziem do tworzenia kontenerów jest Docker. I to od niego najczęściej zaczyna się przygoda z konteneryzacją.Porównanie – wirtualizacja kontra kontenery
| Cecha | Wirtualizacja | Konteneryzacja |
|---|---|---|
| System operacyjny | Każda maszyna ma swój | Wspólny system hosta |
| Start aplikacji | Wolniejszy | Szybki jak błysk |
| Zużycie zasobów | Duże | Minimalne |
| Izolacja | Bardzo wysoka | Wystarczająca dla większości zastosowań |
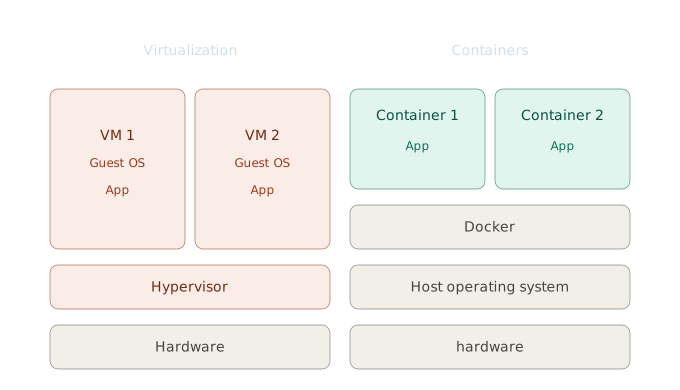
Kubernetes, jako dyrygent całego chaosu
Jedna aplikacja w jednym kontenerze? Prosto. Dziesięć aplikacji w stu kontenerach? Już nie tak bardzo.
Tu pojawia się Kubernetes – system do zarządzania kontenerami, a właściwie podami, czyli grupami kontenerów działających razem. Automatyzuje wszystko: uruchamianie, restartowanie, skalowanie i aktualizacje.
Jeśli nie masz ochoty od razu go stawiać (i dobrze!), są gotowe rozwiązania w chmurze:
- Amazon ECS – wrzucasz kontener, AWS się nim opiekuje, ale Ty nadal decydujesz, na jakich serwerach (EC2) to wszystko działa
- AWS Fargate – nawet nie wiesz, na czym działa – po prostu działa. Zero serwerów do zarządzania, płacisz tylko za to, co faktycznie zużywasz
- Google Cloud Run i Azure Container Apps – podobne podejście co Fargate, czyli „bezserwerowe” kontenery, tylko w innych chmurach
Różnica w skrócie: ECS to „zarządzasz infrastrukturą, ale ktoś Ci pomaga”, a Fargate/Cloud Run/Container Apps to „zapomnij, że infrastruktura w ogóle istnieje”. Na początek – im mniej myślenia o serwerach, tym lepiej.
A jeśli masz ochotę się z nim pobawić – już niedługo pojawi się artykuł, w którym pochylimy się nad tym tematem.
Jak zacząć w 15 minut
Teoria teorią, ale pierwszym krokiem do mistrzostwa jest po prostu zacząć. Oto najkrótsza możliwa ścieżka:- Zainstaluj Dockera (WSL + Docker Desktop na Windows/Mac, albo
Dockerna Linuksie) - Odpal swój pierwszy kontener:
docker run hello-world– jeśli zobaczysz powitalny komunikat, wszystko działa - Spróbuj czegoś bardziej namacalnego:
docker run -d -p 8080:80 nginxi wejdź nalocalhost:8080w przeglądarce - Napisz własny
Dockerfiledla swojej apki – wystarczą dwie-trzy linijki na start - A na deser, jeśli zostanie ci jeszcze minutka, możesz spróbować napisać drugi Dockerfile, stworzyć drugi kontener (np. z bazą danych) i niech ta dwójka ze sobą gada
Typowe błędy na początku
Zanim zaczniesz się zachwycać kontenerami, kilka pułapek, w które często się wpada na dzień dobry:- Trzymanie danych w kontenerze – kontener to nie miejsce na bazę danych czy pliki, które mają przetrwać restart. Kontener umiera, dane giną. Od tego są wolumeny, czyli dodatkowa przestrzeń podpinana do kontenerów, z której dane nie przepadają
- Jeden gigantyczny kontener na wszystko – backend, baza, cache w jednym obrazie to prosta droga do bólu głowy. Jedna aplikacja = jeden kontener, to podstawowa zasada. Jak trzeba czegoś więcej, to stawiamy kilka kontenerów i niech się komunikują
- Ignorowanie rozmiaru obrazu – obraz oparty o pełnego Ubuntu, gdy wystarczyłby Alpine, to trochę jak pakowanie walizki na weekend tak, jakbyś się przeprowadzał
- Brak
.dockerignore– bez niego do obrazu wleci całynode_modulesi historia gita, a build będzie trwał wieczność
Po co to wszystko?
- Twoje aplikacje działają tak samo lokalnie i na produkcji
- Nie boisz się już aktualizacji systemu i innych „niespodzianek”
- Łatwiej wdrażać, testować i skalować aplikacje
- DevOps staje się mniej tajemniczy, a bardziej… logiczny
Na końcu dnia nie chodzi o to, czy znasz wirtualizację, kontenery czy Kubernetes. Chodzi o to, czy rozumiesz, po co każde z nich istnieje i kiedy sięgnąć po które. A narzędzie? To tylko kolejny element naszej DevOpsowej układanki. Wirtualizacja, kontenery i Kubernetes to tematy-rzeki, więc jeśli chcesz zejść głębiej – dokumentacja Dockera i oficjalne tutoriale Kubernetesa to dobry następny przystanek.
A jeśli wolisz poczekać, aż ktoś zrobi tę robotę za Ciebie – zostań z nami. Kolejne wpisy będą schodzić coraz głębiej pod wodę, aż w końcu dobijemy do samego Kubernetesa i jego całej armady.